TimesFM 3.0 시계열 파운데이션 모델 분석
 Ethan· 2026. 11. 4.· 10분 읽기· 조회 6· 댓글 0
개요
TimesFM은 Google Research가 공개한 시계열 예측용 사전학습 모델이다. 판매량, 전력 수요, 센서 값처럼 시간 순서가 있는 데이터를 입력하면 데이터셋별 학습 없이 미래 값과 예측 구간을 산출한다.
2026년 8월 공개된 3.0은 여러 시계열의 동시 예측과 공변량을 모델 구조에 직접 포함하였다. 다만 코드와 3.0 가중치의 라이선스가 다르므로, 사용 목적에 따라 선택지가 달라진다.
참고
2026년 11월 4일 기준 저장소 코드와 공식 문서를 분석한 글이다. 모델을 직접 실행하거나 벤치마크를 재현하지는 않았으므로, 성능 수치는 Google의 공개 자료를 인용한 값이다.
| 항목 | 내용 |
|---|---|
| 최신 패키지 | timesfm 3.0.2 (2026년 9월 9일 PyPI 배포) |
| 모델 규모 | 파라미터 330M |
| 사전학습 규모 | 실제 · 합성 데이터 합계 1조 개 이상의 시점 |
| 추론 백엔드 | PyTorch, MLX(Apple Silicon) |
| 저장소 코드 라이선스 | Apache-2.0 |
| 3.0 가중치 라이선스 | TimesFM Non-Commercial License v1.0 |
| 관리형 서비스 | BigQuery ML, Connected Sheets, Vertex Model Garden |
배경
전통적인 시계열 예측에서는 데이터셋마다 ARIMA 같은 통계 모델을 조정하거나 딥러닝 모델을 학습한다. TimesFM은 언어 모델의 사전학습 방식을 시계열에 적용하여, 처음 접하는 데이터도 추가 학습 없이 예측하는 zero-shot 방식을 목표로 한다.
기본 구조는 ICML 2024 논문에서 제시되었다. 시계열을 일정 길이의 패치로 분할하여 토큰처럼 처리하고, 인코더 없이 디코더 형태의 어텐션 모델로 예측한다.
3.0의 사전학습 데이터는 모델 카드에 GiftEvalPretrain, Wikipedia 페이지 조회 수, Google Trends 상위 검색어, 합성 · 증강 데이터로 기재되어 있다.
버전별 변화
| 항목 | 2.0 | 2.5 | 3.0 |
|---|---|---|---|
| 파라미터 | 500M | 200M | 330M |
| 최대 컨텍스트 | 2,048 | 약 16,000 | 15,360 |
| 시계열 입력 | 단변량 | 단변량 | 단변량 · 다변량 |
| 공변량 | XReg 라이브러리로 별도 처리 | XReg 라이브러리로 별도 처리 | 모델 입력에 직접 포함 |
| 가중치 라이선스 | Apache-2.0 | Apache-2.0 | 비상업 전용 |
2.5는 frequency 입력을 제거하였고, 3.0은 다변량과 공변량을 모델 구조에 포함하였다. 기능 범위는 3.0이 넓지만 가중치의 사용 범위는 2.5가 넓으므로, 용도에 따라 2.5가 적합한 경우도 존재한다.
TimesFM 3.0 구조
패치와 토큰
입력은 32개 시점 단위의 패치로 분할되고, 각 토큰은 64개 시점 분량의 예측을 출력한다. 입력은 세 종류로 구분된다.
| 입력 | 미래 값 | 예시 | 배열 형태 |
|---|---|---|---|
| 타깃 | 예측 대상 | 매장별 판매량 | (변수 수, 컨텍스트) |
| 과거 공변량 | 알 수 없음 | 과거 유동 인구 | (변수 수, 컨텍스트) |
| 과거-미래 공변량 | 알고 있음 | 예정된 프로모션, 날씨 예보 | (변수 수, 컨텍스트 + 예측 구간) |
과거-미래 공변량의 토큰은 현재 패치에 미래 패치를 연결한 형태이다. 예측 시점의 예정 정보를 모델이 미리 참조하기 위한 구조이다.
교대 어텐션
3.0의 핵심은 시간 방향과 변수 방향의 어텐션을 번갈아 적용하는 구조이다. 시간 방향에서는 같은 시계열의 과거 토큰만 참조하여 미래 정보의 유입을 차단하고, 변수 방향에서는 같은 시점의 다른 시계열을 참조하여 상호 관계를 반영한다.
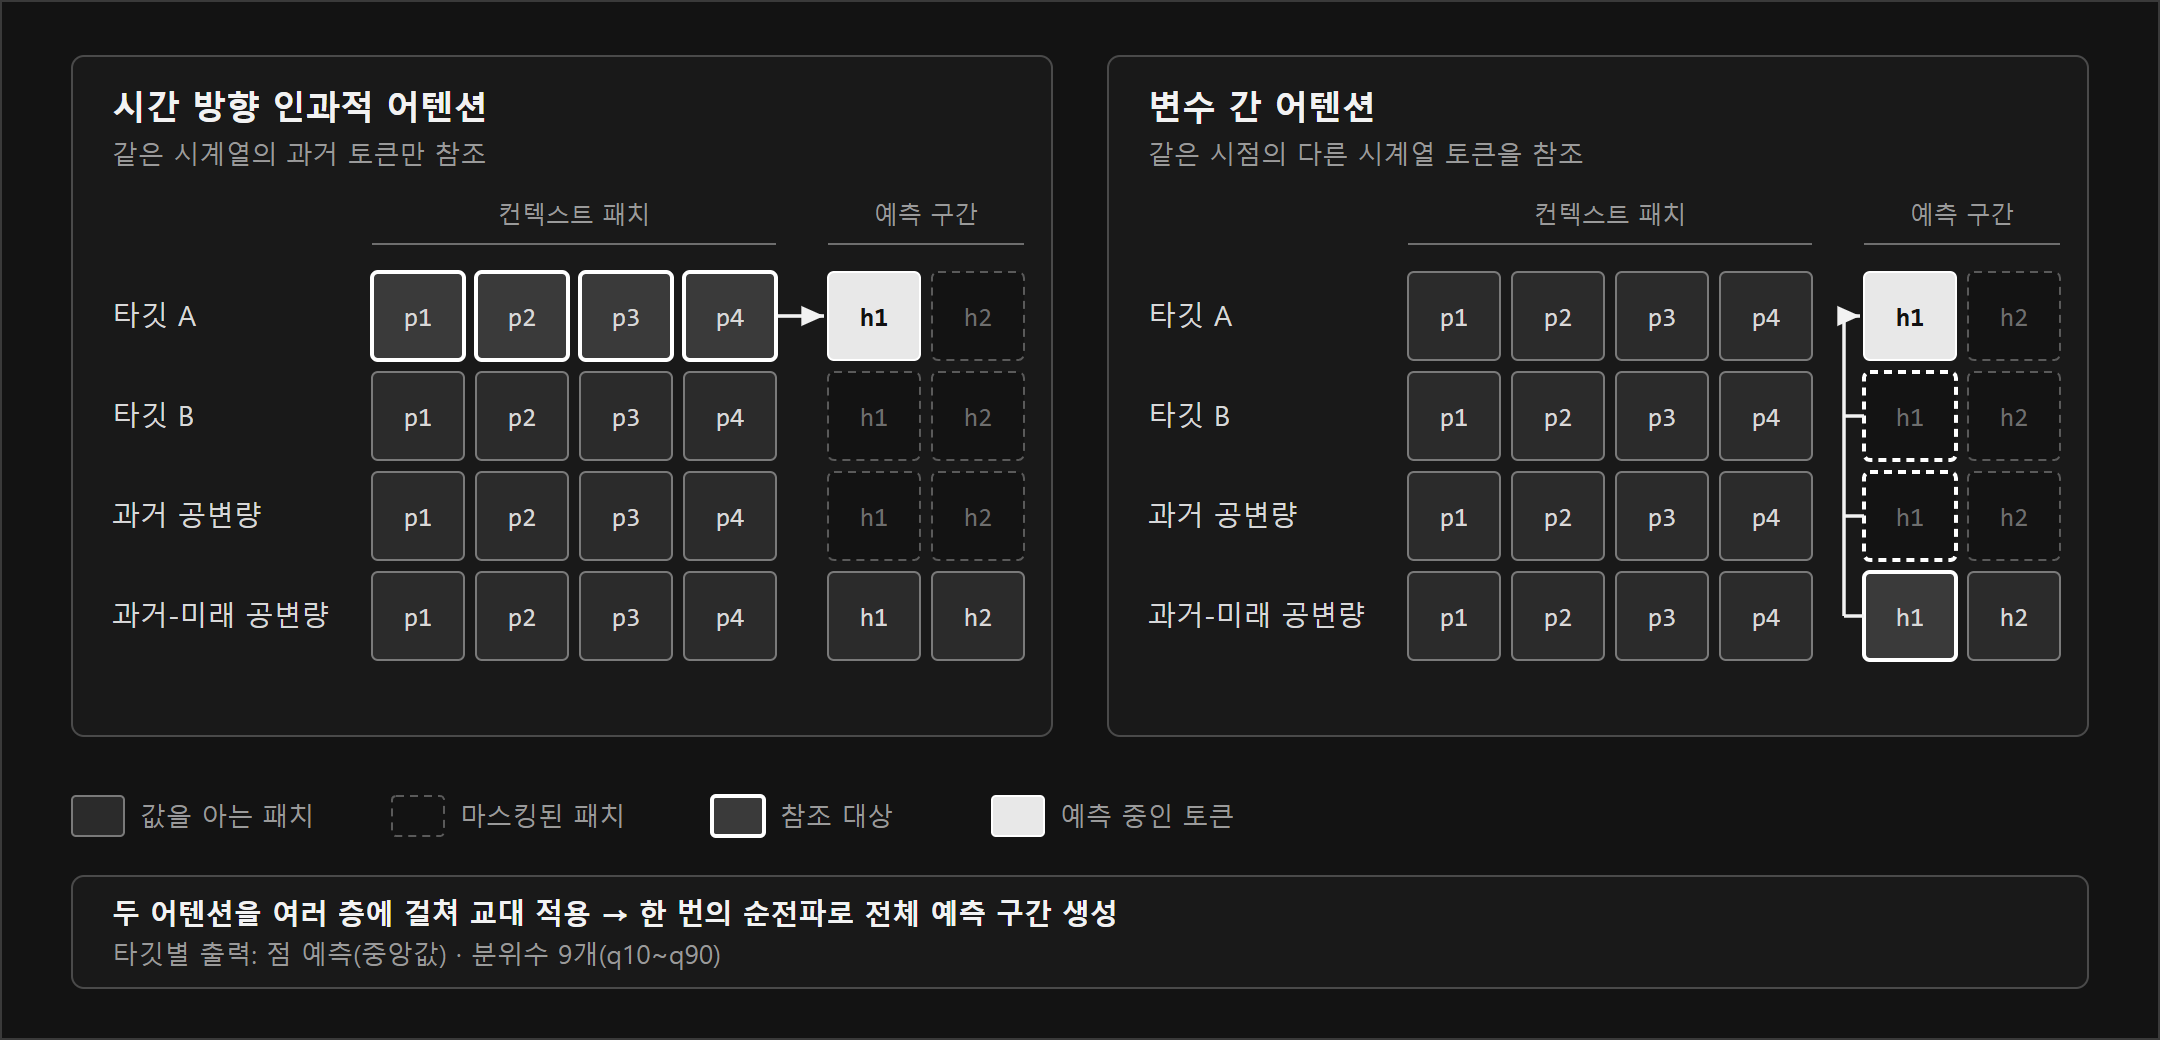
위 그림의 h1이 예측 대상 토큰이다. 타깃의 미래 값은 마스킹되어 있으므로, 모델은 같은 시계열의 과거와 같은 시점의 예정 정보를 조합하여 값을 산출한다.
단일 패스 디코딩
공식 블로그에 따르면 이전 버전은 패치 단위로 예측을 반복 생성하여 지연과 오차 누적이 발생하였다. 3.0은 Contiguous Patch Masking(CPM) 으로 예측 구간 전체를 한 번의 순전파로 생성한다. 타깃과 과거 공변량의 미래 구간은 마스킹하고, 과거-미래 공변량만 공개하는 방식이다.
스케일 정규화
시계열은 수치의 규모가 제각각이므로 입력을 시계열별 통계로 정규화하고 출력에서 복원한다(RevIN). 예측 구간에는 관측값이 없어 통계를 산출할 수 없는데, 코드의 cpm_iterative_revin_refine은 앞선 패치의 추정값을 포함하여 통계를 갱신한다.
공개 체크포인트의 주요 설정값은 다음과 같다.
| 설정 | 값 |
|---|---|
| 입력 패치 · 출력 패치 | 32 · 64 |
| Transformer 층 · 차원 · 헤드 | 20 · 1,280 · 16 |
| 분위수 | 0.1 ~ 0.9, 9개 |
| 최대 컨텍스트 | 15,360 시점 |
점 예측은 중앙값(q50)이다. q10~q90 구간은 명목상 80% 구간이며, 이상 탐지에 응용할 때도 이 범위를 기준으로 임계값을 판단한다.
공개된 벤치마크 결과
| 벤치마크 | 범위 | 공개된 결과 |
|---|---|---|
| fev-bench | 예측 과제 100개 | 전체 1위 |
| TIME | 데이터셋 50개, 과제 98개 | 전체 1위 |
| GIFT-Eval | - | 파운데이션 모델 중 1위 |
비교 대상은 Chronos-2, Toto 2.0 계열, TimesFM 2.5이며, 모델 카드에는 사전학습 데이터에서 fev-bench와 중복되는 데이터셋을 제외하였다고 기재되어 있다. 이 결과는 Google의 자체 공개 자료이고, 블로그는 개별 점수 없이 평균 순위 차트를 제시한다. 실제 도입 판단에는 보유 데이터로 기존 모델과 비교하는 절차가 필요하다.
사용 방법
Python
pip install timesfm[torch]   # PyTorch
pip install timesfm[mlx]     # Apple Silicon
아래는 README의 다변량 예제를 축약한 것이다. 시계열 3개를 공변량과 함께 24개 시점만큼 예측한다.
import numpy as np
from timesfm3 import TimesFM3Evaluator, ModelConfig

forecaster = TimesFM3Evaluator(ModelConfig(
    checkpoint_path="google/timesfm-3.0-pytorch",
    per_core_batch_size=16,
    device="cuda",
))

context_len, horizon = 128, 24
target = np.random.randn(3, context_len).astype(np.float32)
past_only = np.random.randn(1, context_len).astype(np.float32)
past_future = np.random.randn(2, context_len + horizon).astype(np.float32)

output = list(forecaster.predict_batch(
    contexts=[target],
    horizon=horizon,
    past_only_covariates=[past_only],
    past_future_covariates=[past_future],
    return_quantiles=True,
    use_symmetric_averaging=False,
))[0]

print(output.forecast.shape)   # (3, 24)
print(output.quantiles.shape)  # (3, 24, 9)
TimesFM3Evaluator는 벤치마크용 기본값을 사용한다. 그중 make_positive=True는 입력이 음수 없는 시계열이면 예측값의 하한을 0으로 제한하므로, 음수가 가능한 지표에서는 입력 조건을 확인한다. 이 클래스는 한 번의 순전파에 변수를 최대 32개까지 처리하고, 그보다 많으면 자동으로 분할한다.
BigQuery
운영 환경에서는 SQL 함수 AI.FORECAST를 사용할 수 있다. 아래는 문서의 인자를 기준으로 작성한 예시이며 실행 결과는 아니다.
SELECT *
FROM AI.FORECAST(
  TABLE `myproject.mydataset.daily_sales`,
  data_col => 'revenue',
  timestamp_col => 'order_date',
  id_cols => ['store_id'],
  model => 'TimesFM 3.0',
  horizon => 14,
  confidence_level => 0.9);
| 항목 | TimesFM 2.5 | TimesFM 3.0 |
|---|---|---|
| 기본 모델 여부 | 기본값 | 명시 필요(문서상 Preview) |
| 예측 구간 | 1 ~ 10,000 | 1 ~ 1,024 |
| 최대 컨텍스트 | 15,360 | 2,048 |
| 다변량 | 미지원 | 지원 |
BigQuery의 3.0 컨텍스트 상한은 직접 실행 시의 15,360보다 작다. 오래된 이력이 중요한 데이터라면 이 차이를 확인한다.
사용 조건
주의
3.0 가중치의 비상업 라이선스는 내부 벤치마크, 연구, 실험 목적을 허용하지만 결과를 상업적 의사결정, 고객 납품물, 유료 서비스에 사용하는 경우는 제외한다. 회사 데이터로 시험하는 경우에도 결과의 활용 범위를 먼저 확인한다. 아래 표는 요약이며, 적용 여부는 라이선스 원문으로 판단한다.
| 대상 | 라이선스 | 상업 · 운영 사용 |
|---|---|---|
| 저장소 코드 | Apache-2.0 | 가능 |
| 2.5 이하 가중치 | Apache-2.0 | 가능 |
| 3.0 가중치 직접 호스팅 | TimesFM Non-Commercial v1.0 | 불가 |
| BigQuery 등 Google Cloud 서비스의 3.0 | Google Cloud 약관 | 가능 |
Apache-2.0 코드로 3.0 가중치를 불러와도 가중치의 제한은 유지된다. 또한 상업용 모델의 학습과 파인튜닝도 비상업 목적에서 제외되어 있다.
도입 시 판단 기준
| 상황 | 적합한 선택 |
|---|---|
| 개인 실험, 연구, 비상업 평가 | 3.0 가중치 직접 실행 |
| 사내 운영 + 직접 호스팅 + 단변량 | 2.5 가중치 |
| 사내 운영 + 다변량 · 공변량 | BigQuery의 TimesFM 3.0 |
| 도메인 데이터로 미세 조정 | 2.5와 LoRA 예제 |
| 계수 해석 필요 | ARIMA 등 통계 모델 |
저장소의 자료 일부는 아직 2.5를 기준으로 한다. Agent Skill의 문서와 LoRA 파인튜닝 예제가 2.5를 대상으로 하고, 3.0의 PyTorch 구현은 코드 주석에 추론 전용으로 명시되어 있다. 3.0의 미세 조정이나 에이전트 연동을 계획한다면 이 범위를 먼저 확인한다.
참고: TimesFM 저장소 · TimesFM-3 공식 블로그 · 논문 · 모델 카드 · BigQuery TimesFM 문서
댓글
아직 댓글이 없습니다.
댓글을 작성하려면 GitHub로 로그인하세요.